전체 글 106

기능 정의서

프로젝트명RPA를 활용한 환율변동 추이 분석 시스템작성일2025년 10월 18일작성팀미래환율팀 (백인호, 최홍석, 이지석, 이주영, 이병철) 1. 자동화 기능 (RPA / CI/CD)RPA Tool을 이용한 자동화 요구사항을 CI/CD 파이프라인으로 구현합니다.기능명데이터 수집 및 전처리 자동화설명매일 지정된 시간에 환율 및 경제 지표 데이터를 자동으로 수집하고 전처리합니다.구현 기술GitHub Actions프로세스1. GitHub Actions 스케줄러가 매일 1회(예: 오후 1시) 워크플로우를 트리거합니다. 2. Python 스크립트(collector.py)를 실행하여 외부 API/사이트에서 데이터를 수집합니다. 3. 수집된 데이터를 Kafka 토픽으로 전송합니다.출력MongoDB에 저장된 최신 원..
요구사항 정의서

프로젝트명RPA를 활용한 환율변동 추이 분석 시스템문서 버전v1.0작성일2025.10.18프로젝트 기간2025년 9월 2일(화) ~ 10월 15일(수)작성 기준기업주도형 프로젝트 #2 가이드 1. 개요1.1. 프로젝트 배경본 문서는 'RPA를 활용한 환율변동 추이 분석 시스템' 프로젝트의 세부 수행 내용과 요구사항을 정의하기 위해 작성되었습니다. 1.2. 프로젝트 목적주요 통화 및 관련 지수 데이터를 수집, 저장, 처리하는 데이터 파이프라인을 구축합니다.시계열 분석 또는 머신러닝/딥러닝 기법을 사용하여 향후 환율 변동을 예측합니다.분석 및 예측 결과를 사용자가 확인할 수 있도록 인터랙티브 웹으로 구현하고 배포합니다.RPA 도구를 활용하여 데이터 수집 및 분석, 예측 값 업데이트 과정을 자동화합니다1.3...

[Python 머신러닝] 중고차 가격 예측 모델 만들기 (RandomForestRegressor)

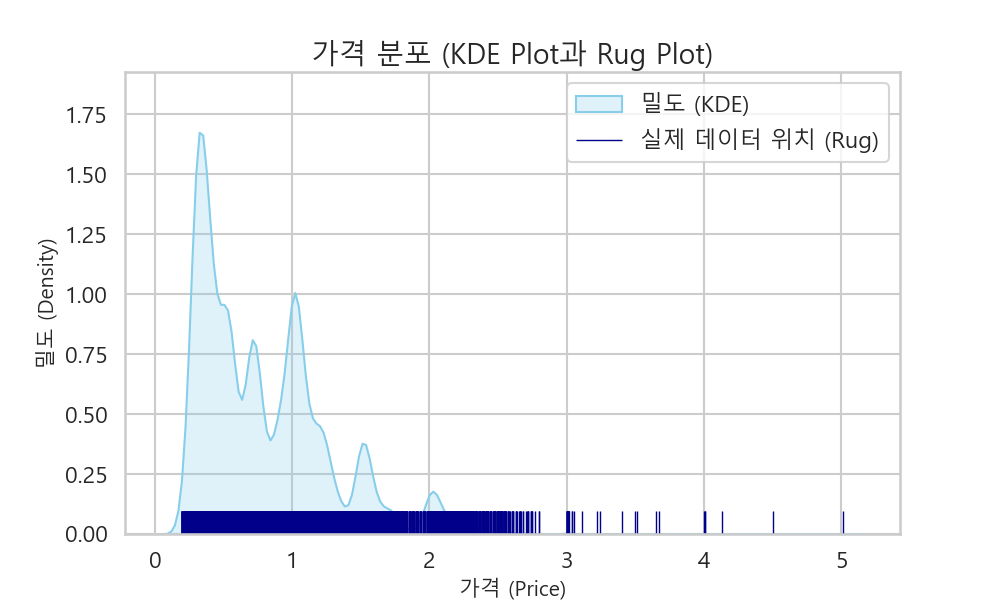
안녕하세요! 이번 파이널 프로젝트에서는 분류(Classification) 문제에 이어, 회귀(Regression) 문제에 도전해 보았습니다. 주어진 데이터셋을 활용하여 "이 중고차의 사양을 보고, 적절한 가격은 얼마일지"를 예측하는 머신러닝 모델을 만들어 보겠습니다.데이터 전처리부터 모델 학습, 성능 평가, 그리고 어떤 요인이 중고차 가격에 가장 큰 영향을 미치는지 분석하는 과정까지, 전체 흐름을 공유합니다. 1. 데이터 준비: 4개의 파일 불러오기이번에 사용한 데이터셋은 특이하게도 훈련(Train)/테스트(Test) 데이터가 문제지(X)와 정답지(y)로 나뉘어 총 4개의 파일로 제공됩니다. pandas를 이용해 각각 불러옵니다.import pandas as pdimport numpy as npimpor..

통계 2025.08.28

[Python 머신러닝] 항공 승객 만족도 예측 모델 만들기 (feat. RandomForest)

안녕하세요! 이번 파이널 프로젝트에서는 캐글(Kaggle)의 항공 승객 만족도 데이터를 사용하여 "승객이 이번 비행에 만족했을지, 불만족했을지"를 예측하는 머신러닝 모델을 만들어 보았습니다.데이터 전처리부터 모델 학습, 성능 평가, 그리고 어떤 요인이 승객 만족도에 가장 큰 영향을 미치는지 분석하는 과정까지, 전체 흐름을 차근차근 공유해 보겠습니다.1. 데이터 준비: 불러오기 및 탐색가장 먼저, 프로젝트에 필요한 라이브러리들을 불러오고, 주어진 train 데이터와 test 데이터를 pandas를 이용해 로드합니다.import pandas as pdimport numpy as npimport matplotlib.pyplot as pltimport seaborn as snsimport platform# 그래..

통계 2025.08.26

Machine learning Project Work Flow # titanic

1단계: 데이터 준비 및 탐색 (Data Preparation & Exploration)목표: 데이터의 속성을 파악하고, 앞으로 처리해야 할 문제점들을 식별하는 단계.1-1. 데이터 불러오기가장 먼저 분석할 데이터를 불러옵니다.import pandas as pdimport seaborn as snsdf = sns.load_dataset('titanic') 1-2. 데이터 훑어보기 (EDA - Exploratory Data Analysis)데이터가 어떻게 생겼는지, 어떤 정보를 담고 있는지 파악합니다..head() / .tail(): 데이터의 앞/뒤 일부를 보며 컬럼과 값들을 눈으로 확인합니다..info(): 가장 중요한 첫 단계. 데이터프레임의 '신분증'과 같습니다.왜?: 각 컬럼의 데이터 타입(obje..

통계 2025.08.24

데이터 시각화

Diamonds 데이터셋을 이용하여 matplotlib, seaborn, plotly package 내 함수를 이용하여 Diamonds 내 주요 정보 도출하가 위하여 다음의 그래프를 시각화하고 insight를 도출하 시오.◼ Dataset: -----------------------------------import seaborn as sns df = sns.load_dataset('diamonds') df-----------------------------------◼ Graph: scatter plot, barplot, barhplot, line chart, areaplot, histogram, pie chart, box plot, 3D graph, lmplot, countplot, heatmap, j..

팀과제 2025.08.22

Machine learning & Deep learning # 3

3. 합성곱신경망(Convolutional Neural Network) Pizza or Not Pizza 데이터 셋 대상으로 합성곱신경망을 사용하여 이미지 분류예측을 실행 하고 parameter 최적화를 통해 최적의 분석모델 수립하시오. 분류성능지표(accuracy, f1 score, ROC-AUC 등)를 산출하고 insight를 도출할 수 있도록 시각화 하시오.◼ Pizza or Not Pizzadatatset =================== import kagglehub # Download latest version path = kagglehub.dataset_download("carlosrunner/pizza-not-pizza") print("Path to dataset files:", path..

팀과제 2025.08.22

Machine learning & Deep learning # 2

2. 다중회귀(Multiple Regression) 소매점의 수요 예측을 위하여 다중회귀기법 3가지 이상을 사용하고 parameter 최적화를 통해 최적의 분석모델 수립하시오. 회귀성능지표(MAE, MSE, RMSE, MAPE)를 산출하고 insight를 도출할 수 있도록 시각화 하시오.◼ Dataset: kaggle site에 있는 Retail Store Inventory and Demand Forecasting https://www.kaggle.com/datasets/atomicd/retail-store-inventory-and-demand-forecasting◼ Train/Test dataset 분할비율은 default 사용(80%-20%)◼ sklearn.model_selection.train_t..

팀과제 2025.08.22

Machine learning & Deep learning # 1

1. 다중분류(Multi-class Classification)고등교육기관에서 생성한 데이터셋을 분석하여 정규과정이 끝나는 시점에서의 결과 (dropout, enrolled, and graduate)의 다중분류예측을 위하여 3가지 이상 다중분류모델을 사용하고 parameter 최적화를 통해 최적의 분석모델 수립하시오. 분류성능지표(accuracy, f1 score, ROC-AUC 등)를 산출하고 insight를 도출할 수 있도록 시각화 하시오.◼ Dataset: https://archive.ics.uci.edu/dataset/697/predict+students+dropout+and+academic+suc cess◼ Train/Test dataset 분할비율은 default 사용(80%-20%)◼ Cla..

팀과제 2025.08.22